Incidents
Sur cette page
Un incident est la trace d'un problème détecté par une sonde : il indique ce qui a échoué, depuis quand, qui a été notifié et ce que l'équipe a fait. C'est par les incidents que vous commencez quand quelque chose ne va pas — ouvrez-les depuis Monitoring → Incidents, depuis une notification ou depuis l'application mobile.
Quand un incident s'ouvre et se ferme#
- Il s'ouvre au premier contrôle en échec. Il n'y a ni nouvelle tentative ni délai d'attente : dès qu'un contrôle échoue, l'incident s'ouvre avec l'heure de ce contrôle, et les intégrations liées à la sonde sont notifiées. Les sondes Serveur font exception : elles n'ouvrent un incident que lorsqu'une ressource reste au-dessus de son seuil pendant la durée configurée.
- Il reste ouvert tant que le problème dure. Onagre n'envoie pas de rappels : une notification à l'ouverture, une à la fermeture.
- Il se ferme au premier contrôle réussi. L'incident est résolu automatiquement, sa durée est enregistrée, et une notification de rétablissement part vers les mêmes intégrations. Il n'y a rien à fermer à la main.
Une sonde a au plus un incident ouvert à la fois. Supprimer une sonde ferme son incident ouvert (« Closed — resource deleted ») ; la mettre en pause, ou une fenêtre de maintenance, arrête les contrôles et laisse donc un incident ouvert jusqu'à la reprise des contrôles.
Sévérité#
Chaque incident porte la sévérité de sa sonde : Critical, Major, Minor ou Info. Elle se règle sur la sonde (Schedule and severity) et permet de trier et filtrer les incidents par importance. Elle ne change pas qui est notifié : c'est le rôle de l'alerting de la sonde.
Prendre en charge un incident#
Prendre en charge un incident, c'est dire à l'équipe « Je m'en occupe ». Cliquez sur Acknowledge sur un incident ouvert et indiquez ce que vous faites dans What are you doing about it? (au moins 5 caractères).
L'incident passe à Acknowledged et votre commentaire rejoint son activité. La prise en charge n'arrête pas les contrôles, ne résout pas l'incident et n'envoie aucune notification : l'incident se ferme toujours de lui-même lorsque le contrôle réussit. Elle évite simplement que deux personnes enquêtent sur le même problème sans le savoir.
Prendre en charge et commenter nécessitent le rôle User. Depuis l'application mobile, la prise en charge ajoute le commentaire « Acknowledged from mobile ».
La page d'un incident#
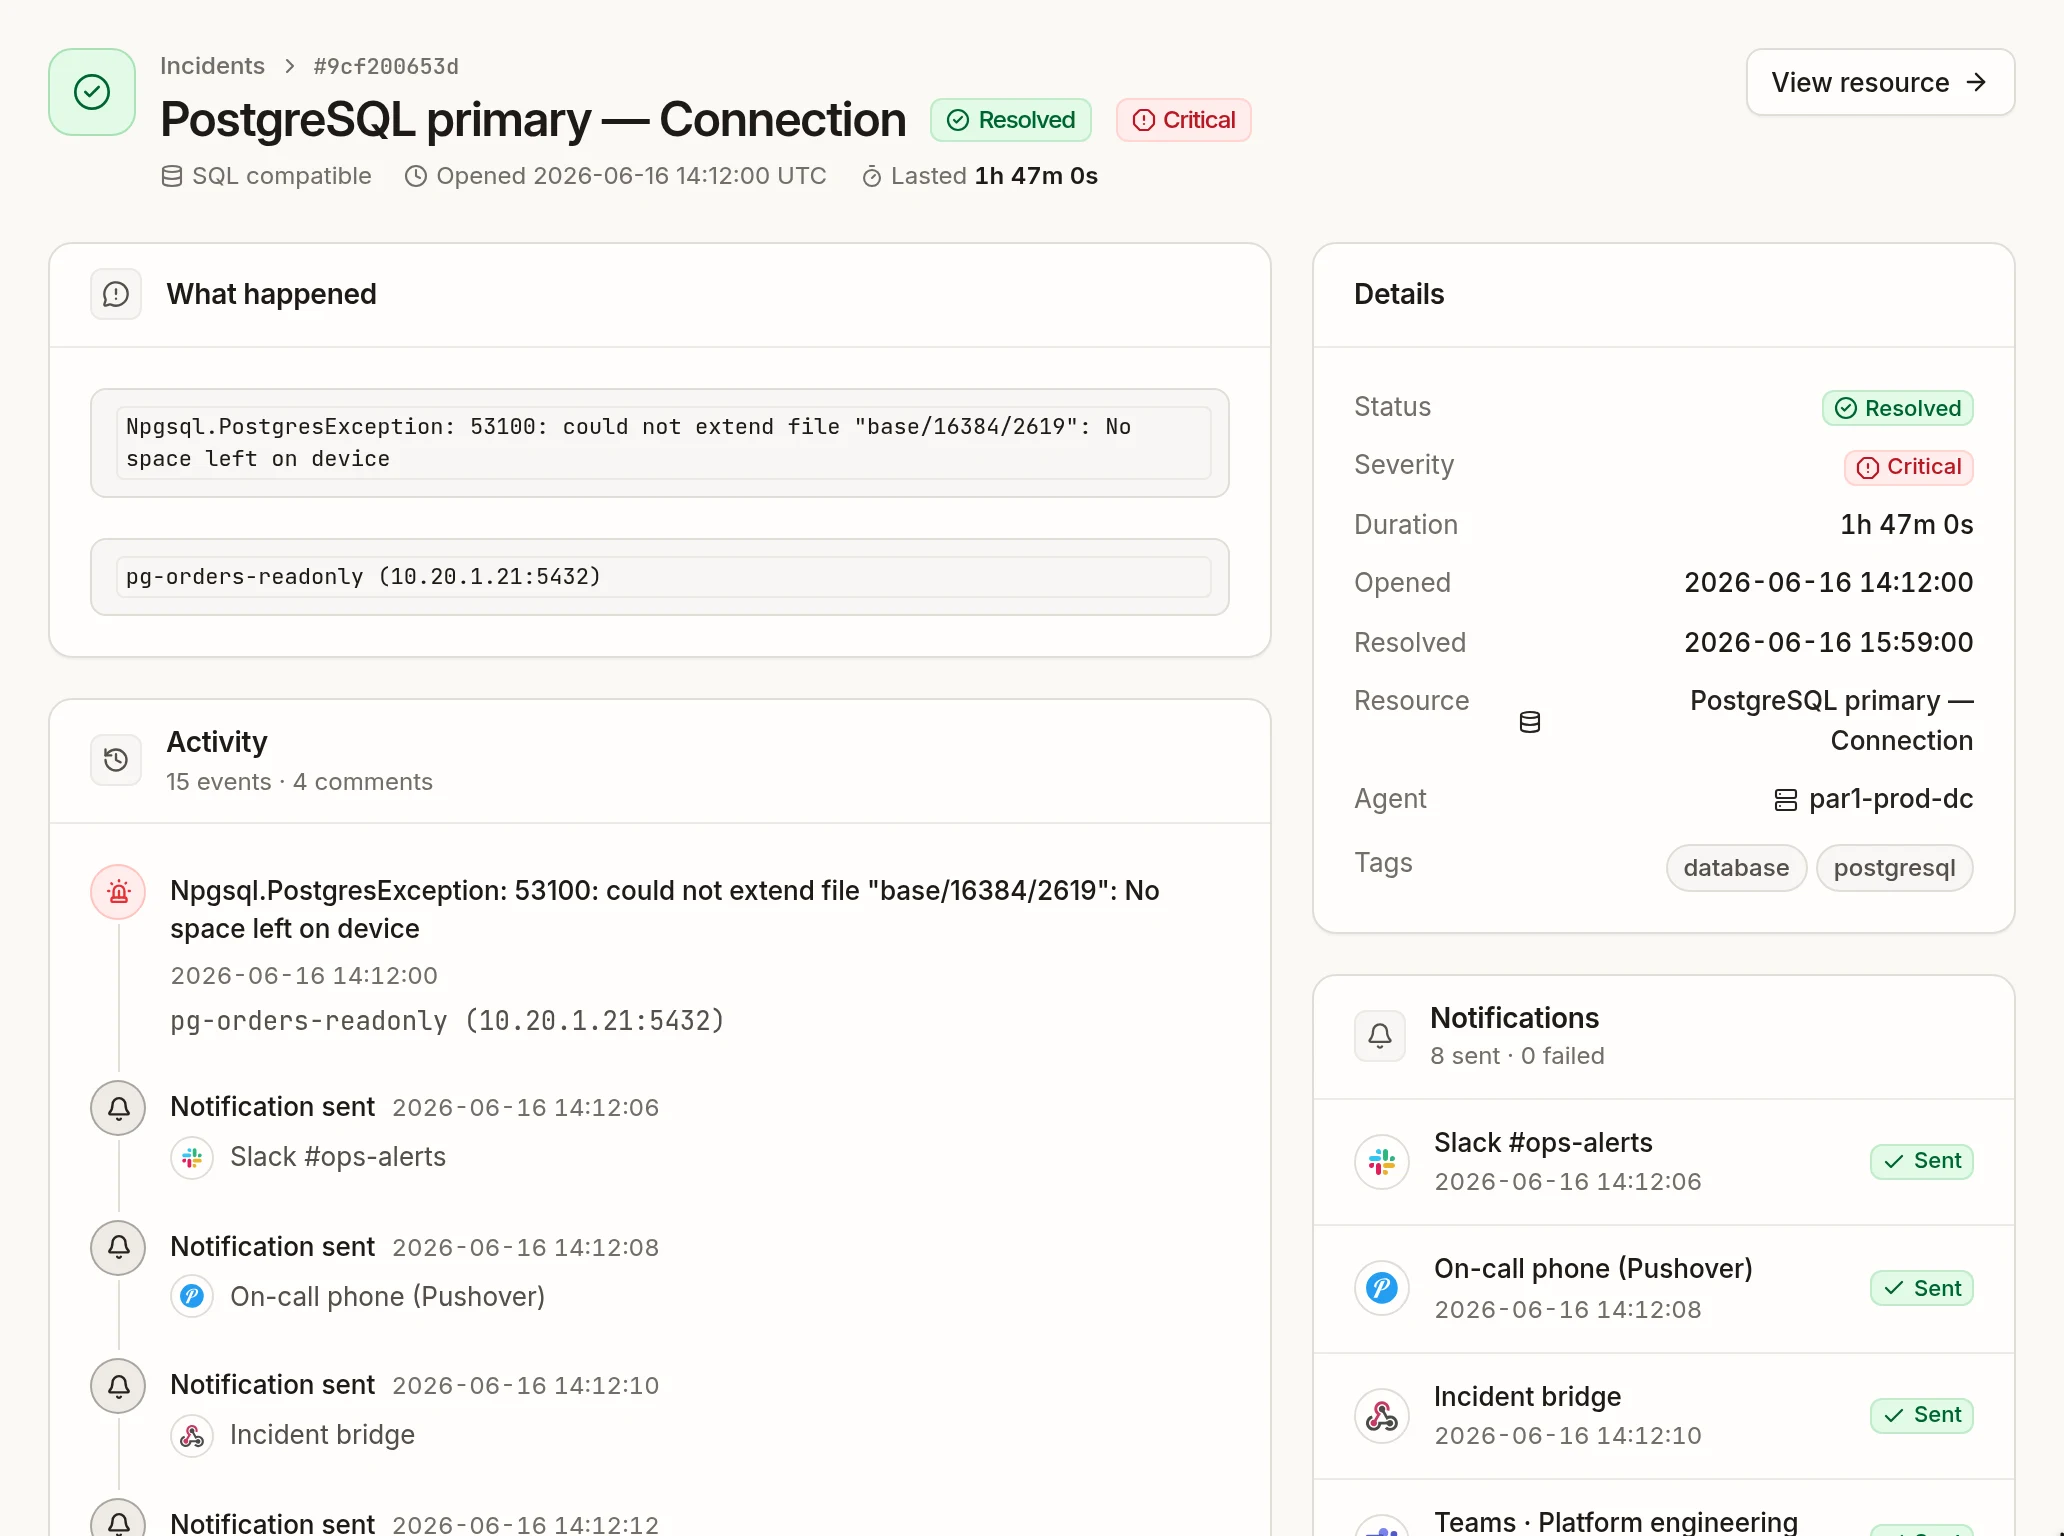
- En-tête — la sonde, le statut (Open, Acknowledged ou Resolved), la sévérité, l'heure d'ouverture et la durée écoulée. View resource ouvre la sonde.
- What happened — l'erreur remontée par le contrôle : un statut HTTP, un délai dépassé, une erreur de base de données, une valeur inattendue…
- Details — statut, sévérité, durée, heures d'ouverture et de résolution, sonde, agent et tags.
- Activity — tout ce qui s'est passé, dans l'ordre : l'échec, chaque notification envoyée (ou en échec), la prise en charge, les commentaires de l'équipe, la résolution.
- Notifications — chaque intégration notifiée, marquée Sent ou Failed.
- Dependencies — les autres sondes qui dépendent de celle en échec, avec leur état actuel, pour évaluer l'impact.
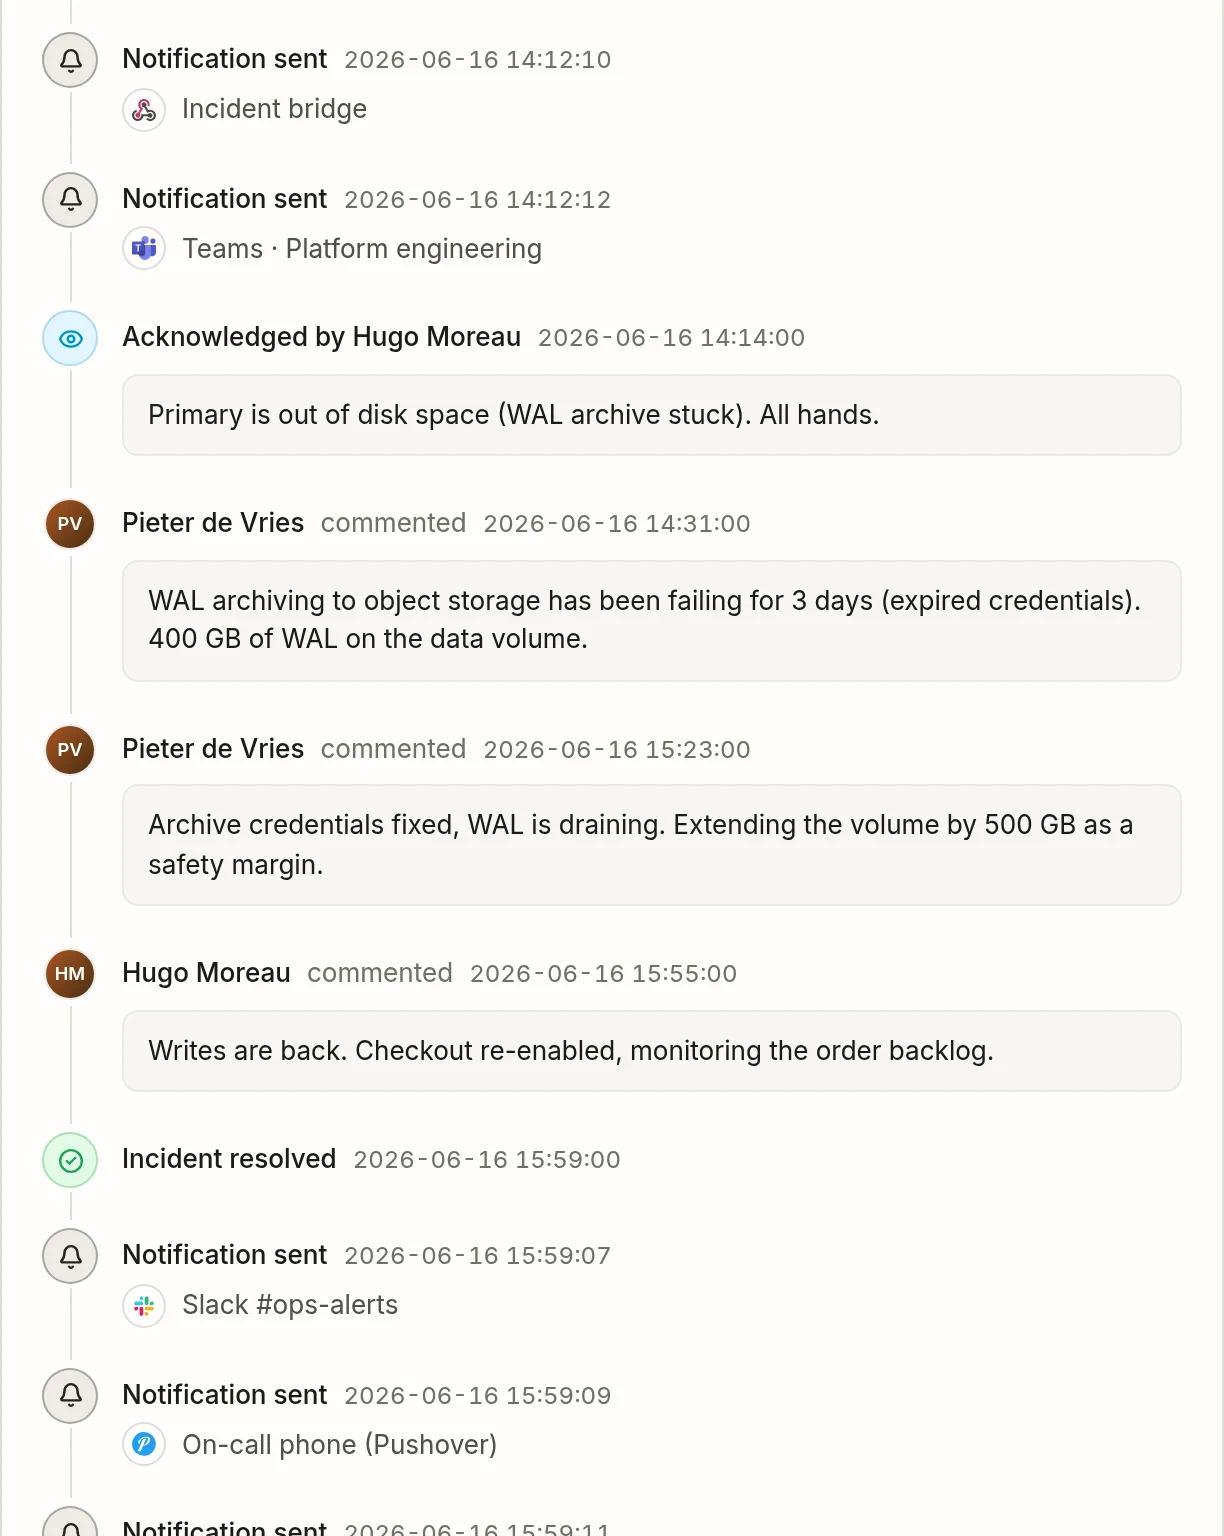
Toute personne ayant le rôle User peut ajouter un commentaire — avancement, constats, lien vers le post-mortem — à tout moment, y compris après la résolution.
La page des incidents#
Monitoring → Incidents couvre les 30 derniers jours.
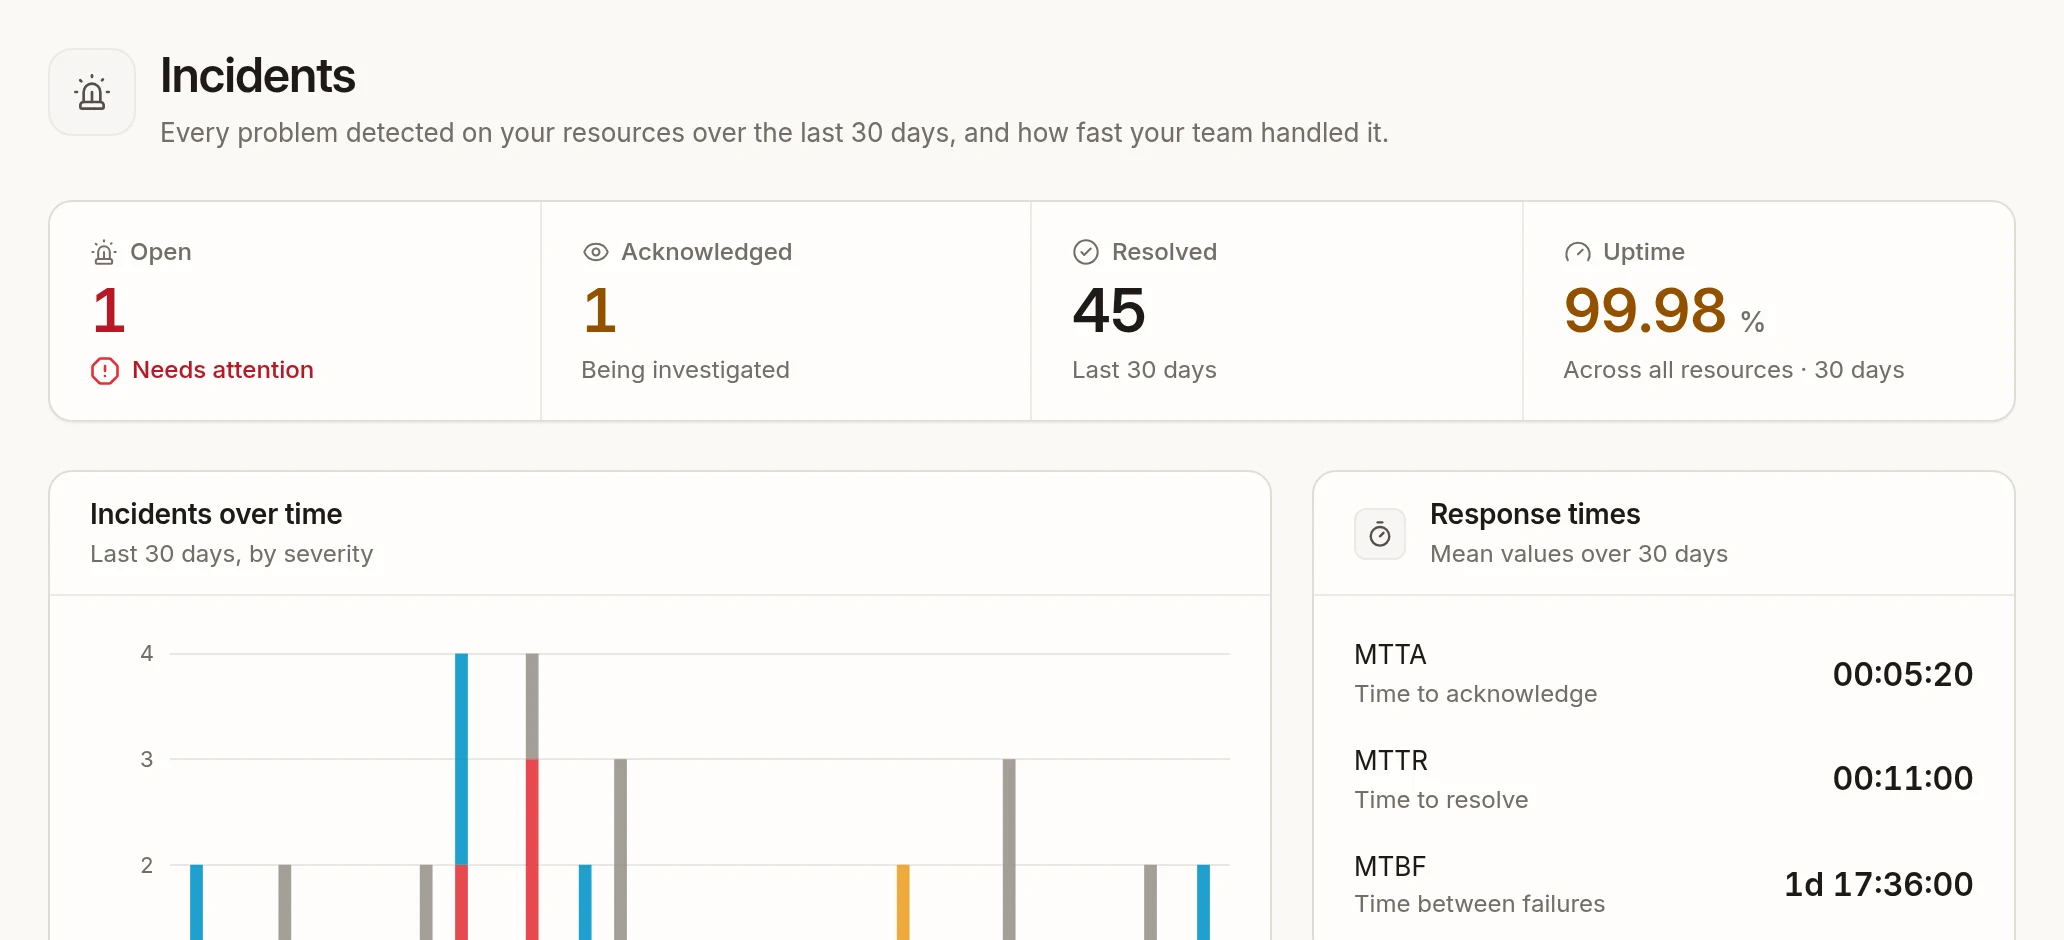
- Open, Acknowledged, Resolved et Uptime sur l'ensemble des sondes.
- Incidents over time — incidents par jour, par sévérité.
- Response times — les moyennes de l'équipe sur 30 jours :
- MTTA, délai de prise en charge : de l'ouverture à la prise en charge ;
- MTTR, délai de résolution : de l'ouverture à la résolution ;
- MTBF, temps entre pannes : la fréquence à laquelle les sondes échouent.
- Longest downtime et Most incidents — les cinq sondes qui ont le plus souffert.
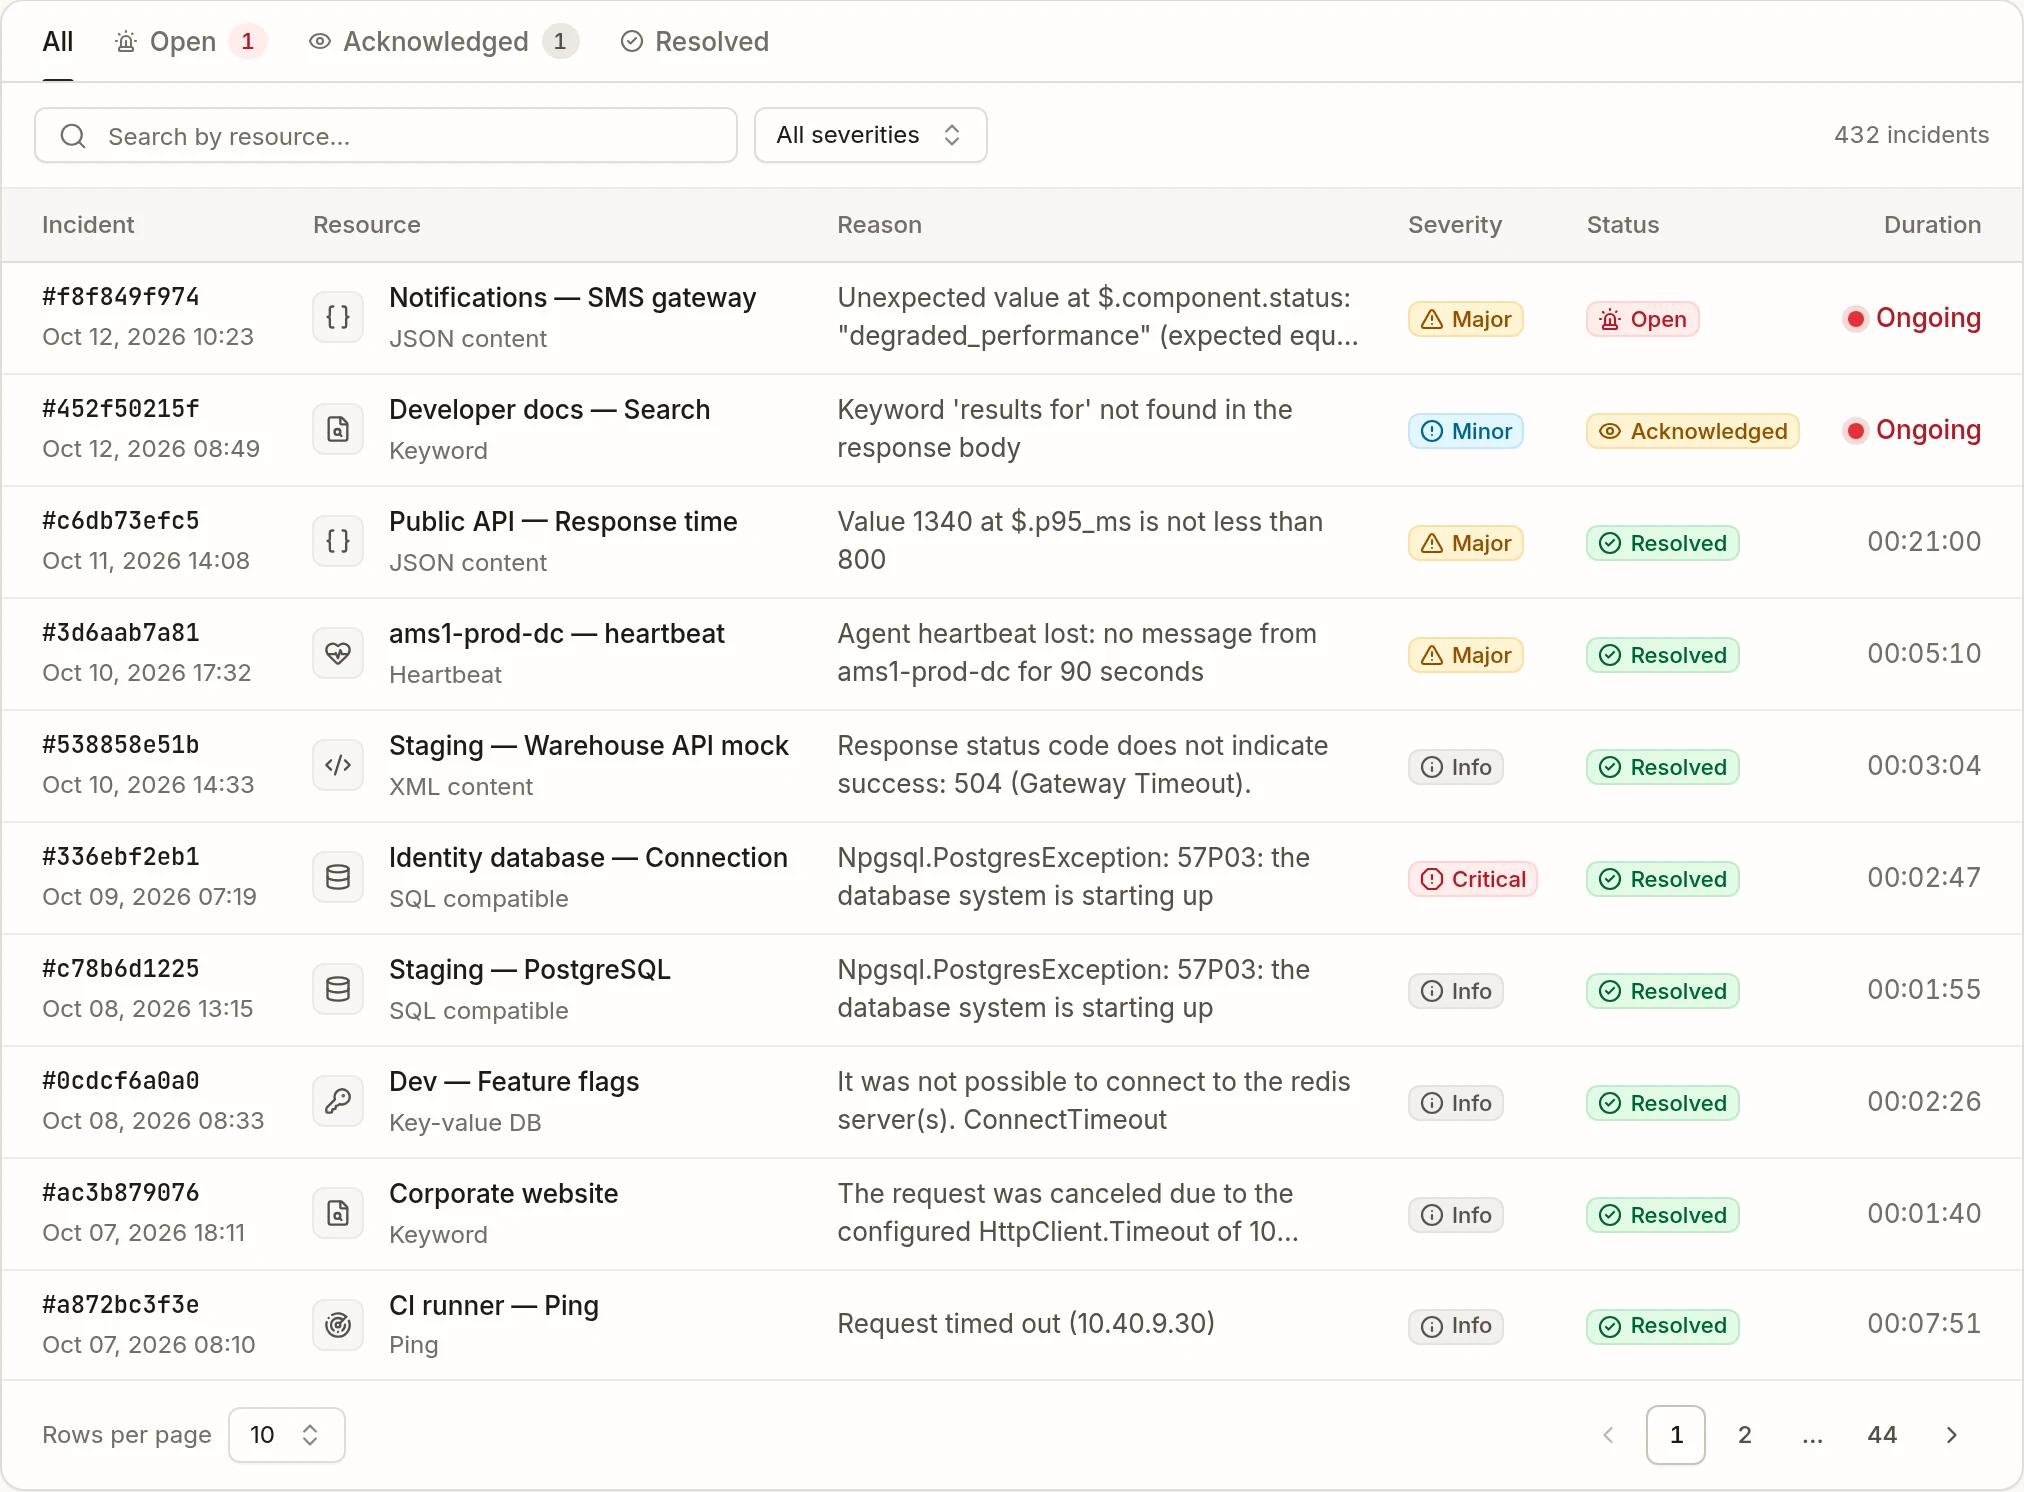
La liste en dessous peut être filtrée par statut (All, Open, Acknowledged, Resolved), par sévérité et par nom de sonde, 10, 25 ou 50 par page.
Voir aussi#
- Alerting et notifications — qui reçoit quoi, et quand.
- Propagation des incidents — comment un service en échec affecte les services qui en dépendent.
- Fenêtres de maintenance — éviter les incidents pendant des travaux planifiés.