Résultats et historique
Sur cette page
Chaque contrôle est enregistré. La page d'une sonde — ouvrez-la depuis Resources ou depuis un incident — transforme ces résultats en réponses utiles : est-elle en service, à quelle vitesse répond-elle, à quelle fréquence échoue-t-elle, et qu'est-ce qui a changé.
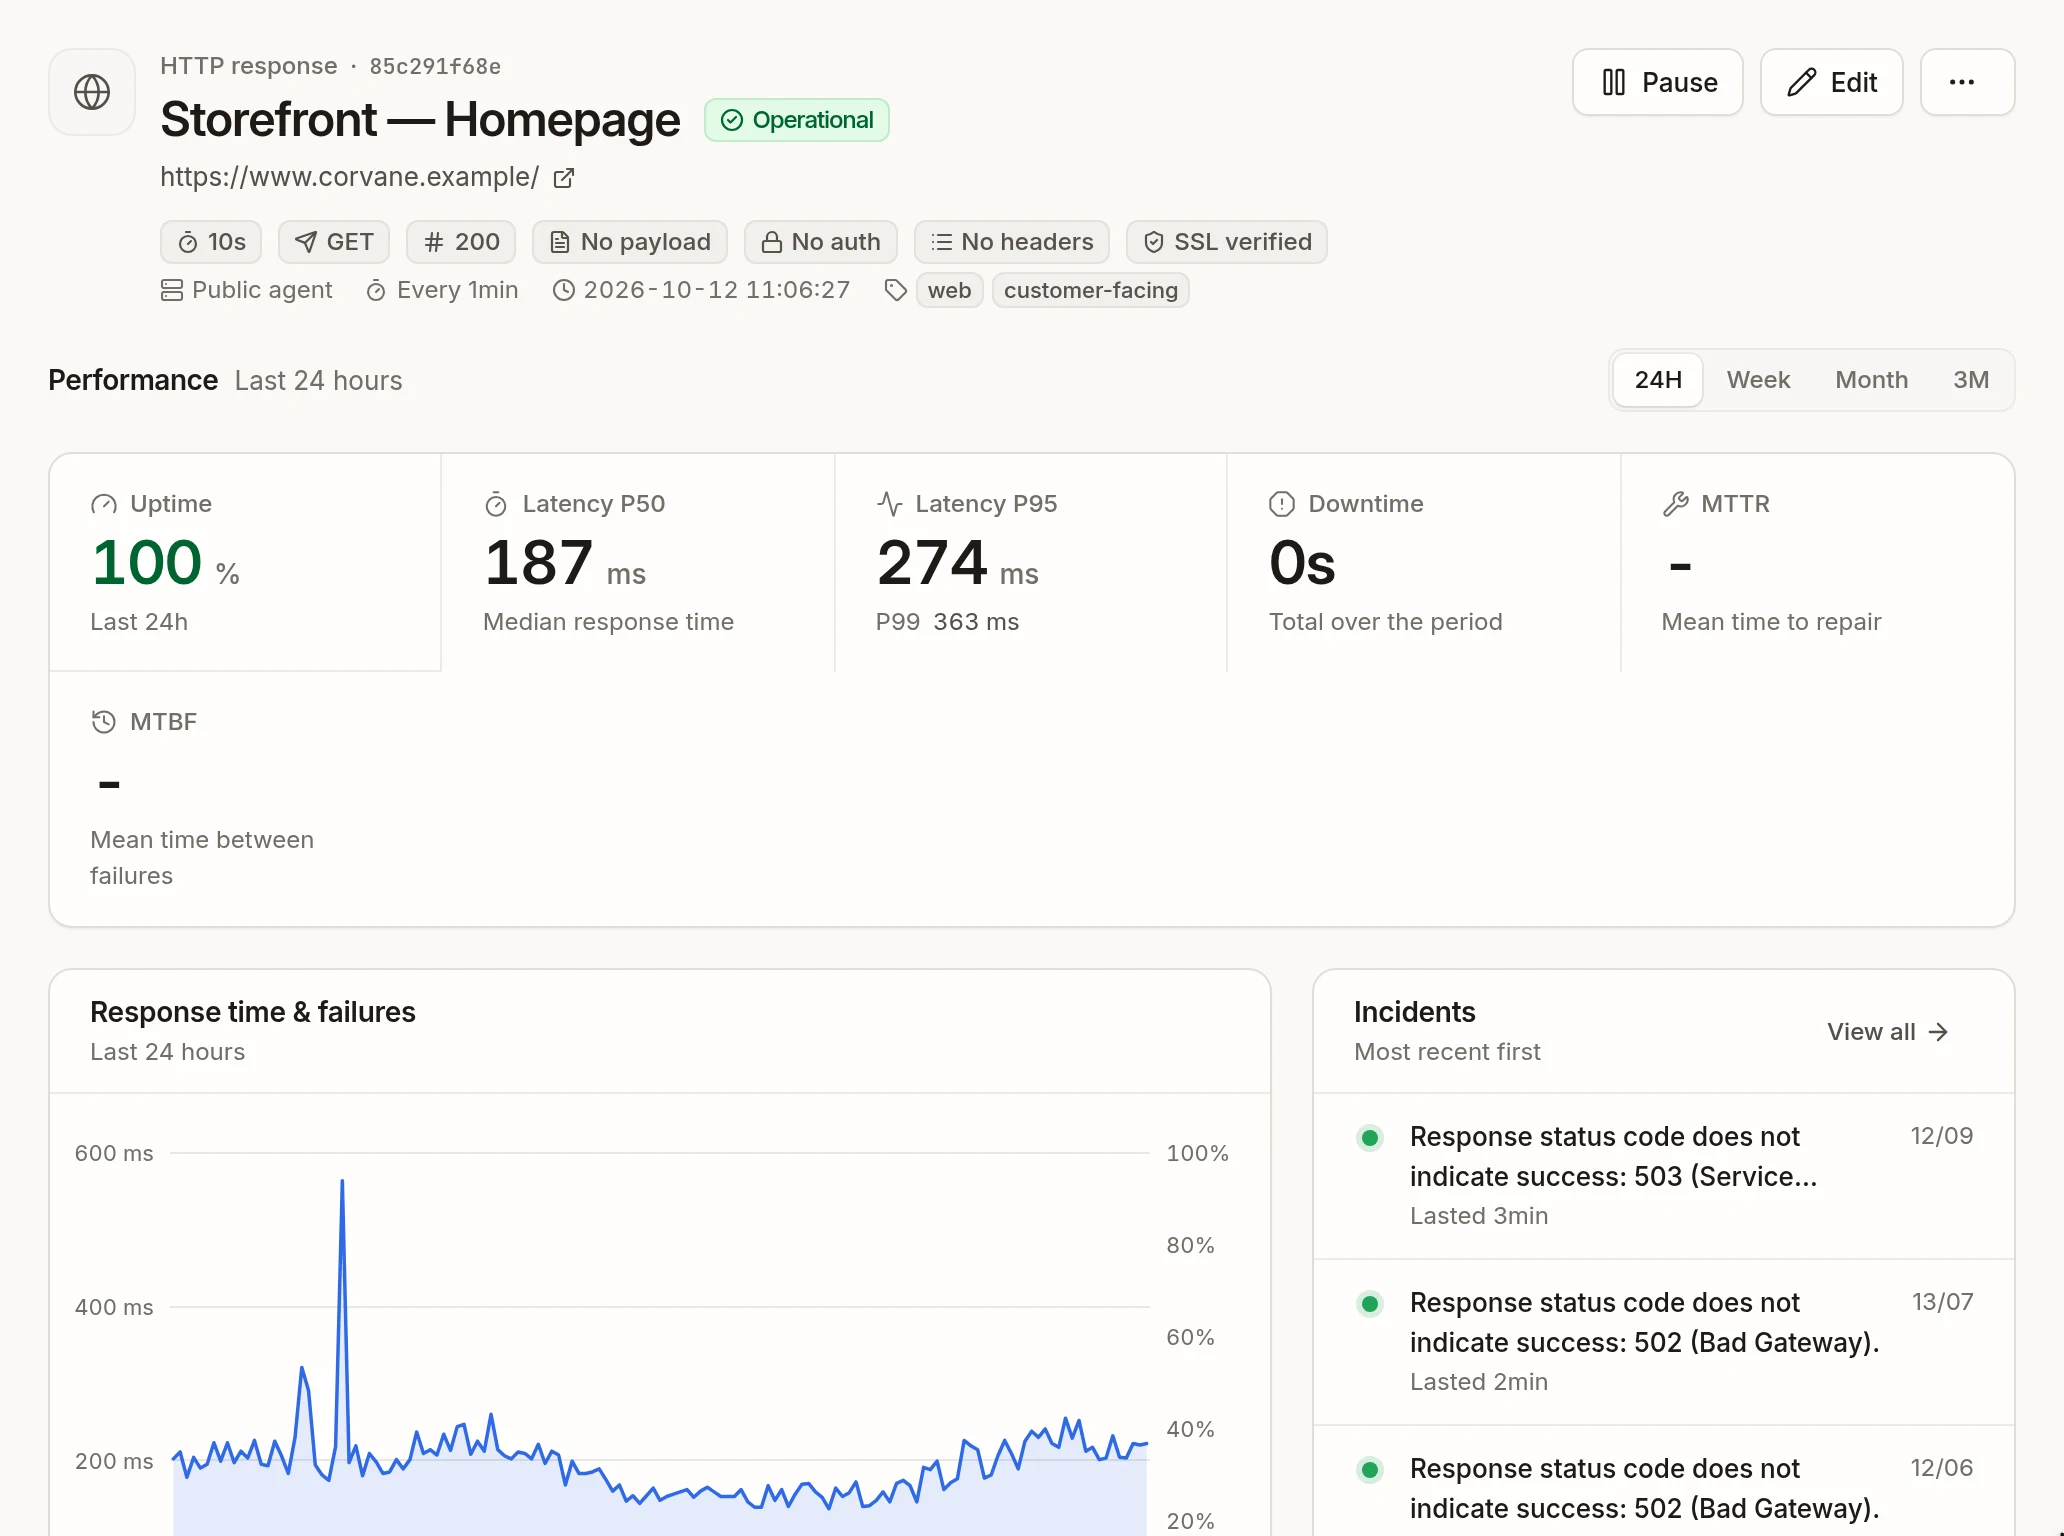
En-tête#
L'en-tête affiche le nom et le code de la sonde, son état actuel (Operational, Down, Pending, Late ou Paused), la cible qu'elle contrôle, sa configuration en un coup d'œil (délai, méthode, codes acceptés…), l'agent qui l'exécute, sa planification, ses tags et l'heure du dernier contrôle. Pause, Edit et More actions se trouvent à droite.
Performances#
Choisissez la période — 24H, Week, Month ou 3M — puis lisez :
| Indicateur | Signification |
|---|---|
| Uptime | Part des contrôles réussis sur la période. |
| Latency P50 | Temps de réponse médian : la moitié des contrôles ont été plus rapides. |
| Latency P95 | 95 % des contrôles ont été plus rapides que cette valeur ; le P99 est affiché en dessous. |
| Downtime | Durée totale passée avec un incident ouvert. |
| MTTR | Temps moyen de rétablissement : la durée moyenne des incidents. |
| MTBF | Temps moyen entre pannes : combien de temps la sonde reste généralement en service entre deux incidents. |
Graphiques#
Le graphique trace le temps de réponse de chaque contrôle, avec :
- le taux d'échec pour la plupart des types ;
- la valeur mesurée pour les types qui en extraient une — une valeur JSON ou XML, une valeur SQL ou Redis, le nombre de messages dans une file de lettres mortes ;
- les jours restants avant expiration pour un certificat.
Les pics et les paliers rendent les changements visibles : une version plus lente, une migration, un certificat renouvelé.
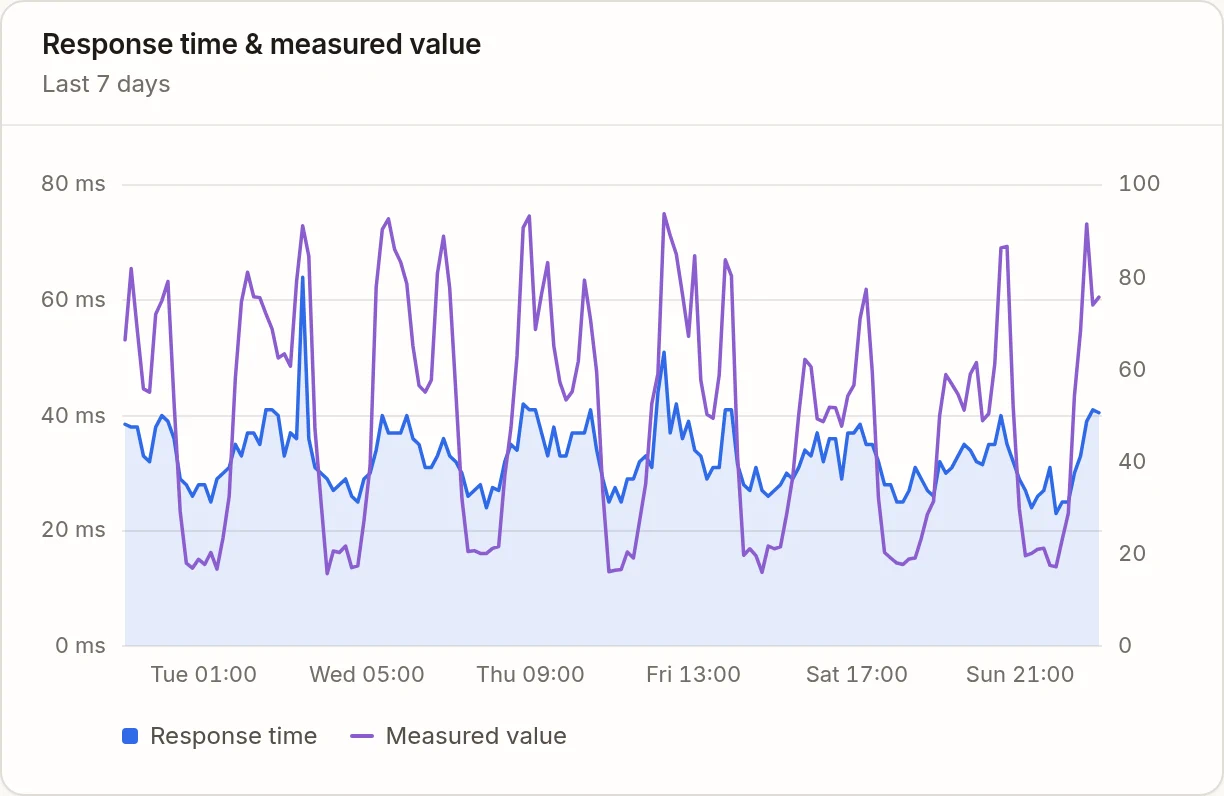
Les sondes Serveur affichent à la place Server health (CPU et mémoire) et Disk space.
Incidents, alerting et services#
- Incidents liste les derniers incidents de la sonde, en cours ou résolus ; cliquez sur l'un d'eux pour l'ouvrir.
- Alerting montre les intégrations notifiées à l'ouverture d'un incident. No alerting configured signifie que les incidents de cette sonde ne notifient personne.
- Service dependencies situe le service de la sonde parmi les services dont il dépend et ceux qui dépendent de lui — voir Service Map.
Historique des modifications#
Change history liste les modifications de configuration apportées à la sonde sur la période sélectionnée : utile lorsqu'une sonde se met à échouer juste après que quelqu'un l'a modifiée.